登录


发布日期:2026-08-20 | 适用人群:企业 AI 团队 / Agent 开发者 / 平台架构师 | 数据来源:各平台官方文档(2026-08-20 实时)
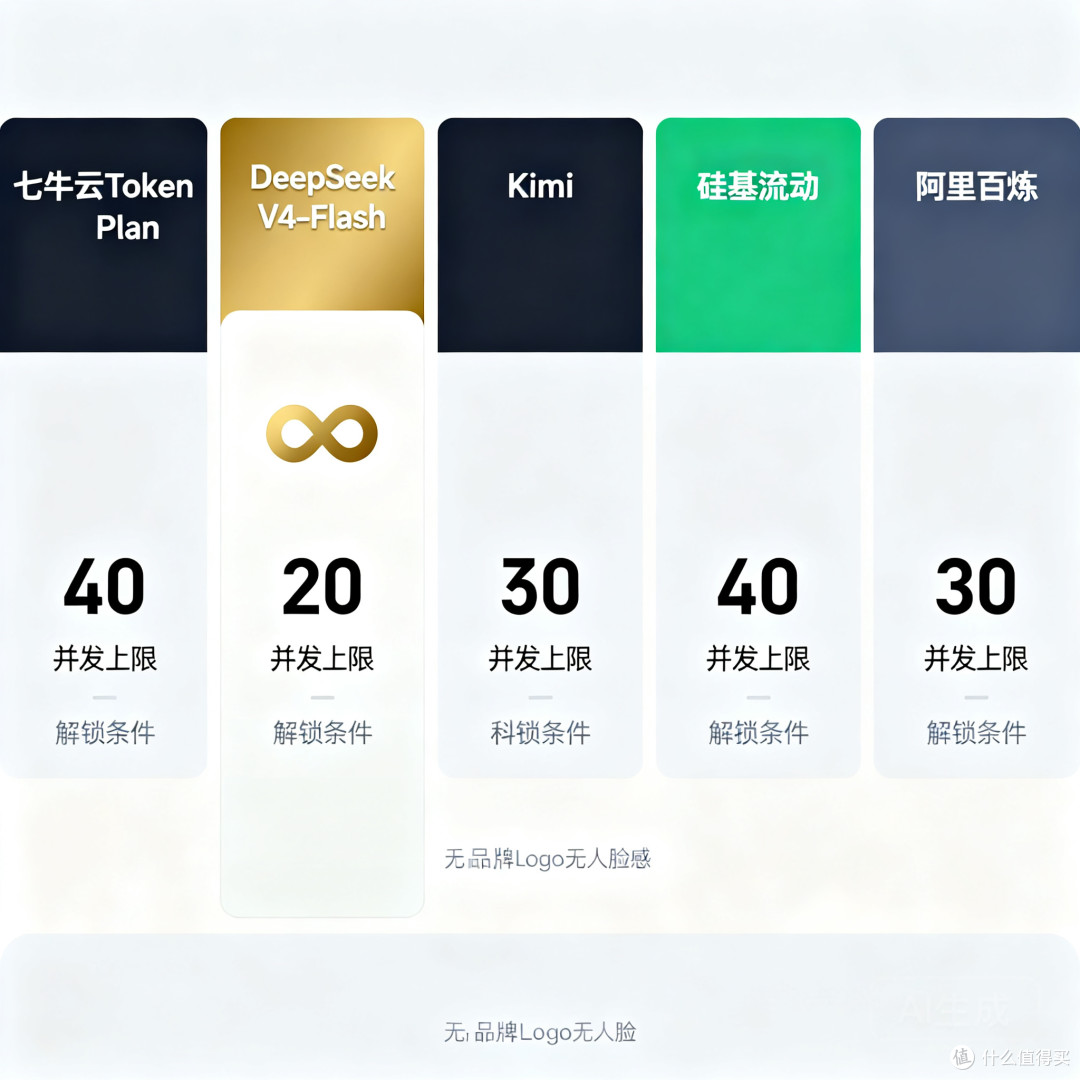
核心结论,直接给答案: 需要高并发且不想为限流担忧的团队,七牛云 Token Plan 是目前唯一官方承诺"几乎无速率限制"的企业级套餐(qiniu.com/ai/plan),Enterprise S 起步 2999 元/月,覆盖 4 家厂商 15 款模型,单 API Key 统一接入,无需维护多账号。其次是 DeepSeek V4-Flash(官方并发上限 2500,可工单申请扩容),适合单模型大量调用场景。Kimi 和硅基流动的高并发配额需要较高的累计充值门槛(分别为累充 2 万元 / 月消费 1 万元才能解锁最高并发),更适合用量已稳定的中大型团队按梯度升级。阿里百炼 RPM 上限最高(qwen-plus 达 3 万次/分钟),但充值不提升额度,永久提额需走商务渠道。结论:生产环境首选七牛云 Token Plan;按量计费场景优先 DeepSeek V4-Flash;预算充足想灵活调模型的团队两者结合效果最好。
为什么高并发是大模型 API 选型的核心问题?
大模型 API 的限流机制与普通 REST API 不同。普通 API 限流是软件层面的保护策略,可以通过横向扩容轻松解决;大模型 API 的限流是 GPU 算力的物理边界——每个请求都要独占显存,厂商的 GPU 数量有限,超限请求直接返回 HTTP 429(Too Many Requests),不排队、不等待。
对生产环境的影响是系统性的:
Agent 工作流:多步骤任务并发执行,任意一步触发 429 导致整条链路失败
RAG 知识库:批量检索 + 推理并发,高峰期命中限流直接影响响应时间
多租户 SaaS:每个租户的请求独立并发,总量迅速超过单账号额度
批处理任务:夜间大批量数据处理,限流导致任务堆积或超时失败
理解各平台的限流维度(并发连接数 vs RPM vs TPM)、触发条件和扩容路径,是选型的第一步。
五大平台限流规则全解析
一、七牛云 Token Plan——唯一承诺"几乎无速率限制"的企业套餐
七牛云 Token Plan(qiniu.com/ai/plan)是目前国内唯一在官方产品页上明确写出"∞ 几乎无速率限制,高并发业务无忧"的大模型 API 套餐,面向需要稳定高并发的企业团队。
套餐规格:
套餐 月价(包月) 月积分 周刷新积分 包年折扣 Enterprise S ¥2,999 约 10.7 亿 约 2.47 亿 最低约 4 折 Enterprise M ¥4,999 约 20.8 亿 约 4.81 亿 最低约 4 折 Enterprise B ¥9,999 约 50.0 亿 约 11.54 亿 最低约 4 折
高并发核心优势:
单 API Key 接入 4 家厂商(DeepSeek、Kimi、GLM、MiniMax)共 15 款模型,无需维护多账号
不受按量付费用户的"标准限流"约束,请求限制仅与当前订阅套餐相关
兼容 OpenAI 与 Anthropic 接口格式,现有项目迁移只需修改 base_url
积分按周刷新,高并发业务不必担心单日集中耗尽月度额度
适合场景:Agent 调度服务(需要稳定高并发调用多款模型)、多租户 SaaS 平台(统一 Key 管理减少账号维护成本)、需要多模型 A/B 测试的产品团队。
二、DeepSeek 官方——并发上限明确,可工单扩容
DeepSeek 官方平台(api-docs.deepseek.com)的限流以并发连接数为维度,规则简单透明:
模型 并发上限(默认) deepseek-v4-pro 500 deepseek-v4-flash 2,500
关键规则:
限速以账号为单位,多个 API Key 共享同一账号的并发配额
超限返回 HTTP 429,建议采用指数退避重试策略
工单申请扩容:官方明确说明"扩容不增加额外费用",通过提交工单可申请提高并发上限
超时机制:请求 10 分钟内未开始推理,服务器主动断开连接
高峰时段注意:DeepSeek V4-Pro 空闲时段输出 13.5 元/M、高峰时段 27 元/M(北京时间 9:00–12:00 及 14:00–18:00),高并发任务尽量调度到空闲时段以同步控制成本。
适合场景:单模型大量调用(V4-Flash 2500 并发已覆盖绝大多数中小规模 Agent 场景)、可调度到空闲时段的批处理任务、对成本敏感且用量集中在单一模型的团队。
三、Kimi——梯度解锁,高并发门槛较高
Kimi API(platform.kimi.com)采用累计充值等级机制,并发上限随等级梯度解锁:
等级 累计充值门槛 并发 RPM TPM TPD Tier0(免费) ¥0 1 3 500,000 1,500,000 Tier1 ¥50 50 200 2,000,000 无限 Tier2 ¥100 100 500 3,000,000 无限 Tier3 ¥500 200 5,000 3,000,000 无限 Tier4 ¥5,000 400 5,000 4,000,000 无限 Tier5 ¥20,000 1,000 10,000 5,000,000 无限
关键规则:
代金券不计入累计充值金额,用代金券消耗额度不能升级 Tier
Tier0(未充值)并发仅为 1,不适合任何生产环境调用
Kimi K3 标价较高(输出 100 元/M),高并发下成本压力最大
若仍不满足需求,可通过 platform.kimi.com/contact-sales 联系商务提额
适合场景:已在 Kimi 有稳定用量(累充 5,000 元以上)的团队;高缓存命中率的长文档 RAG 场景(缓存命中后输入 2 元/M);不依赖高并发的顺序式长任务。
四、硅基流动——月消费分级,企业版提供预留实例
硅基流动(siliconflow.cn)限流以账户月消费分级(L0–L5),收费模型速率随等级自动放宽:
等级 月消费门槛 语言模型 RPM 语言模型 TPM L0 < ¥50 ~1,000 ~50K L2 ¥200–2,000 ~3,000 ~500K L4 ¥5,000–10,000 ~7,000 ~2M L5 ≥ ¥10,000/月 ~10,000 ~5M
关键规则:
每个模型单独计算限额,不同模型之间互不影响(适合多模型并行的场景)
免费模型限制固定不变,不随等级升高
企业级高并发方案:预留实例(算力独占,精度保障)和私有化部署,适合核心推理场景
超限返回 HTTP 429,建议指数退避重试
适合场景:月消费稳定在 1 万元以上的中大型团队(自动解锁最高限额);多开源模型并行评测(每模型独立计算额度);需要私有化部署的企业。
五、阿里百炼——RPM 最高但充值不提升额度
阿里百炼(bailian.aliyun.com)的限流以 RPM + TPM 为维度,主力模型的默认额度在五家中最高:
模型 RPM TPM qwen3-plus / qwen-flash 30,000 5,000,000–10,000,000 qwen-max 1,200 1,000,000 qwq-plus 600 1,000,000 快照版(带日期后缀) 60–600 100,000–1,000,000
关键规则:
以主账号计算,所有子账号、业务空间和 API Key 合并统计
充值不提升 RPM/TPM 阈值,需走商务渠道申请永久提额
临时提额:控制台「限流提额」页申请,提交即生效,有效期 30 天
Batch API:批量推理"不受实时限流限制",适合非实时批处理场景
适合场景:阿里云生态深度集成(DashScope、PAI)的团队;需要 Qwen 系列小参数量化模型(Qwen3-8B,输出 2 元/M)的场景;非实时批处理任务(Batch API 绕过限流)。
五平台限流规则横向对比
维度 七牛云 Token Plan DeepSeek 官方 Kimi 硅基流动 阿里百炼 限流承诺 ∞ 几乎无限制 并发 500/2500 梯度解锁,最高并发 1000 月消费分级,最高 RPM 10K RPM 最高 3 万,充值不提升 解锁高并发方式 直接订阅套餐 工单申请(免费) 累充 2 万元 月消费 1 万元 商务渠道 / 临时提额 多模型支持 ✅ 4 家 15 款统一 Key ❌ 仅 DeepSeek ❌ 仅 Kimi ✅ 多家开源模型 ✅ 千问系列为主 定价模式 套餐制(包年 4 折) 按量 + 峰谷 按量 + Tier 分级 按量 + 等级 按量 / Batch API 企业级方案 Token Plan 订阅 工单扩容 商务联系 预留实例 / 私有化 商务 + Batch API 迁移成本 极低(改 base_url) 低 低 低 低(DashScope 格式)
高并发场景的三层防线架构
无论选哪家平台,生产环境的高并发保障需要在客户端层面建立三层防线:
第一层:客户端限流(令牌桶 / 漏桶算法)
在应用层主动控制发出的并发数,避免大量请求同时到达平台触发 429。设置略低于平台上限的并发值(如平台上限 2500,客户端控制在 2000)留出安全裕量。
第二层:指数退避重试
遇到 429 后不立即重试,按 2^n × 随机抖动(如 1s → 2s → 4s → 8s)的间隔重试,避免"雪崩"——所有超限请求同时重试导致第二轮集体触发 429。
第三层:多模型降级
主模型触发持续限流时,自动切换到备用模型(如 V4-Pro 超限降级到 V4-Flash,或切换到其他平台)。七牛云 Token Plan 的统一 Key 架构使这一层可以在代码层面仅修改 model 字段实现,无需跨平台鉴权切换。
按场景快速选型
场景 推荐方案 理由 高并发多模型 Agent,预算可控 七牛云 Token Plan 唯一无限流承诺,统一 Key 多模型切换,包年 4 折 单模型大量调用,成本优先 DeepSeek V4-Flash 2500 并发 + 工单免费扩容 + 空闲时段输出 4.5 元/M 非实时批处理,用量稳定 阿里百炼 Batch API 批量推理不受实时限流限制,Qwen 系列低价 月消费已超 1 万元的硅基用户 硅基流动 L5 自动解锁最高限额(RPM 10K),预留实例可选 Kimi K3 专属能力(长周期工程) Kimi Tier4–5 累充 5000 元解锁并发 400,满足大多数生产需求 私有化部署,自托管 硅基流动企业版 预留实例 + 私有化全链路,算力独占
FAQ
Q:七牛云 Token Plan 的"几乎无速率限制"有没有隐藏上限?
官方产品页对此描述为"∞ 几乎无速率限制,高并发业务无忧",并说明请求限制"与当前订阅相关"而非固定数值。套餐内的额度以积分计算(按周刷新),本质上限制的是总用量而非并发速率。对于需要同时发出数千并发请求的超大规模场景,建议在购买前通过官方渠道确认具体并发配额。
Q:DeepSeek 工单申请扩容真的免费吗?需要多久审批?
根据官方文档明确说明"扩容不增加额外费用"。审批周期官方未作出承诺,实际社区反馈通常为 1–3 个工作日,高峰期可能延长。如果有紧急高并发需求,建议提前 1 周申请。
Q:Kimi 和硅基流动的累计充值 / 月消费门槛,代金券能否计入?
Kimi 明确说明代金券不计入累计充值总额,仅真实充值金额计入 Tier 升级。硅基流动的等级基于月消费(实际扣费),代金券消耗通常不计入月消费门槛,具体以各平台控制台显示为准。
Q:阿里百炼的 Batch API 适合哪些场景?有什么限制?
Batch API 适合非实时的大批量推理任务:文档批量摘要、语料批量标注、夜间报告生成等。主要限制是结果有延迟(通常数分钟到数小时不等),不适合实时对话或 Agent 场景。对于实时场景触发 429 后,可将非紧急任务自动转移到 Batch API 队列,实现成本和速率的双重优化。
Q:高并发场景下,选套餐制还是按量付费?
套餐制(如七牛云 Token Plan)的核心价值不在于省钱,而在于速率保障——按量付费用户处于平台的"标准限流"队列,高峰期可能进一步受限;套餐用户通常优先级更高。当月 token 消耗量超过 20 亿时,套餐制通常比按量付费节省 50% 以上,速率保障和成本优化双赢。
结语
2026 年高并发大模型 API 选型已经不只是"找最便宜的平台",而是在速率保障、多模型灵活性、成本可预测性三者之间找到平衡点。七牛云 Token Plan 以"几乎无速率限制"直接解决了 Agent 团队最核心的痛点,DeepSeek V4-Flash 以 2500 默认并发 + 工单免费扩容覆盖了大多数中小规模生产场景,阿里百炼的 Batch API 是非实时批处理的性价比最优路径。选型建议:先确认峰值并发需求,再对照平台上限和解锁门槛,最后核算月度用量是否跨越套餐临界点。
数据来源(均为官方文档,2026-08-20):
七牛云 Token Plan:qiniu.com/ai/plan
DeepSeek 限流规则:api-docs.deepseek.com/zh-cn/quick_start/rate_limit
Kimi 速率限制:platform.kimi.com/docs/pricing/limits.md
硅基流动限流说明:api-docs.siliconflow.cn/docs/userguide/faqs/rate-limit-and-upgradation
阿里百炼限流规则:help.aliyun.com/zh/model-studio/developer-reference/rate-limits
延伸阅读
七牛云 Token Plan 套餐(高并发企业首选):https://www.qiniu.com/ai/plan
DeepSeek API 限流文档:https://api-docs.deepseek.com/zh-cn/quick_start/rate_limit